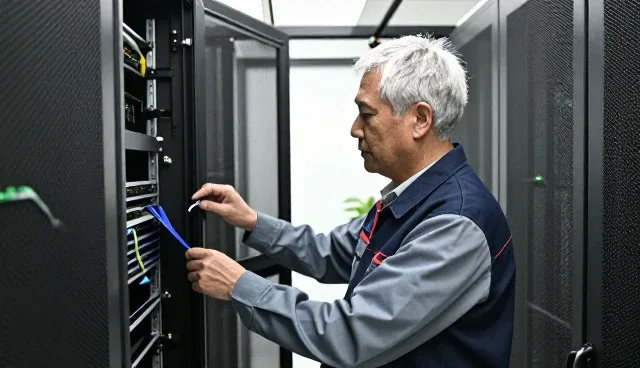
在服务器运维的实际操作中,团队常常面临各种突发问题,如网络中断、系统崩溃或数据丢失等,这些问题可能直接影响业务的正常运转。针对这些情况,团队需要快速识别故障源头,采取有效措施进行修复。例如,当服务器出现响应延迟时,首先应检查网络带宽是否正常,其次是查看系统日志中是否有异常记录。通过逐一排查,可以迅速定位问题并采取相应解决方案,避免影响用户使用体验。
服务器团队在日常工作中还需要处理资源分配不均的问题。当业务高峰期到来,部分服务器负载过高,而其他服务器却处于闲置状态,这不仅浪费了资源,也可能引发性能瓶颈。为解决这一问题,团队通常会采用负载均衡技术,将流量合理分配到不同服务器上,确保系统整体运行效率。同时,定期进行资源使用情况分析,有助于优化资源配置,提高整体运维效率。
在服务器维护过程中,数据安全是团队必须高度重视的环节。无论是意外断电、硬件故障,还是人为误操作,都可能导致数据丢失或损坏。为此,团队应建立完善的备份机制,包括本地备份和远程备份,并确保备份数据定期测试恢复能力。此外,访问权限的合理划分和加密技术的应用,也能有效防止未授权访问带来的安全风险,保障数据的完整性与保密性。
随着业务规模的不断扩大,服务器团队需要面对越来越复杂的系统架构。在这种情况下,自动化监控工具的使用变得尤为重要。通过部署监控系统,团队可以实时掌握服务器运行状态,如CPU使用率、内存占用、磁盘空间等关键指标。一旦发现异常,系统会自动发送告警信息,提醒团队及时处理。这种主动监控机制大大提高了问题发现和响应的速度,降低了人工巡检的工作量。
在团队协作方面,服务器运维往往涉及多个部门的配合,如开发、测试和运维团队。为了提升协作效率,团队应建立清晰的沟通机制和流程。例如,采用敏捷开发模式,确保开发与运维之间的信息同步,减少因沟通不畅导致的问题。同时,定期召开跨部门会议,分享运维经验,探讨改进措施,也有助于提升整体运维水平。
服务器团队在处理问题时,还需要注重知识管理与经验积累。通过建立问题日志和解决方案库,团队可以快速查找历史问题的处理方式,避免重复劳动。此外,定期组织内部培训和案例分享,有助于提升团队成员的技术水平和应对复杂问题的能力。知识共享不仅提高了团队的整体素质,也为后续问题的解决提供了有力支持。
最后,服务器团队应保持对新技术的关注和学习,以应对不断变化的业务需求和技术挑战。例如,云原生架构、容器化技术以及微服务等新兴技术,正在逐步改变传统的服务器运维模式。通过引入这些技术,团队可以提升系统的可扩展性和灵活性,同时降低运维复杂度。持续学习和技术创新,是服务器团队保持竞争力的关键所在。